[컴파일러개론] Bottom-up
Top-down vs Bottom-up
생성규칙 선택을 더 많은 token이 들어올 때까지 미룰 수 있고, left-recursive 문법도 파싱이 가능하기 때문에, Bottom-up이 더 강력하다.
Bottom-Up Parsing
Bottom-up = 우파스 = 우측 유도의 역순
- terminal 심벌들로부터 시작해서 심벌을 유도한다.
- 생성규칙의 rhs와 매치되나 보고 맞으면 lhs로 바꿔치기 반복한다.
- \(E \rightarrow E + T ~|~ T\)
- \(T \rightarrow num ~|~(E)\)
- (1+2+(3+4))+5
- ← (T+2+(3+4))+5
- ← (E+2+(3+4))+5
- ← (E+T+(3+4))+5
- ← (E+(3+4))+5
- ← (E+(T+4))+5
- ← (E+(E+4))+5
- ← (E+(E+T))+5
- ← (E+(E))+5
- ← (E+T)+5
- ← (E)+5
- ← E+5
- ← E+T
- ← E
E부터 ← 방향으로 읽으면 유도와 같다.
LL(k)
- 입력을 left-to-right로 스캔
- Left-most 유도
- k개의 심벌을 lookahead
- [Top-down 또는 recursive descent/predictive] parsing 또는 LL parser
- 파스트리를 pre-order로 순회 및 생성
- 루트 먼저, 칠드런 나중
LR(k)
- 입력을 left-to-right로 스캔
- Right-most 유도
- k 심벌을 lookahead
- [Bottom-up 또는 shift-reduce] parsing 또는 LR parser
- 파스트리를 post-order로 순회 및 생성
- 칠드런 먼저, 루트 나중
Reduce란?
\(S\Longrightarrow\alpha\beta\omega\) 이고, \(A \rightarrow \beta\)의 생성규칙이 존재할 때, 문장형태 \(\alpha\beta\omega\)에서 \(\beta\)를 \(A\)로 대치하는 것을 말한다.
파싱결과는 시작심벌이 나올 때까지 reduce 하면 얻어진다.
예시)
문법
- \(S \rightarrow aAcBe\)
- \(A \rightarrow Ab\)
- \(A \rightarrow b\)
- \(B \rightarrow d\)
Reduce sequence(abbcde)
- abbcde
- ⇒ aAbcde (reduce 3)
- ⇒ aAcde (reduce 2)
- ⇒ aAcBe (reduce 4)
- ⇒S (reduce 1)
위와 같이 밑줄된 부분이 reduce 될 부분이고, 이 부분을 handle이라고 한다.
Handle
\(S \Longrightarrow \alpha A\omega \Longrightarrow\alpha\beta\omega\)의 과정이 있을 때 \(\beta\)를 문장형태 \(\alpha\beta\omega\)의 handle이라고 한다.
예시)
문법
- \(E \rightarrow E+T\)
- \(E \rightarrow T\)
- \(T \rightarrow T*F\)
- \(T\rightarrow F\)
- \(F \rightarrow (E)\)
- \(F \rightarrow a\)
| 유도 (우측유도) | reduce | ||
| E ⇒ E + T | 1 | a + a * a ⇒ F + a * a | 6 |
| ⇒ E + T * F | 13 | ⇒ T + a * a | 64 |
| ⇒ E + T * a | 136 | ⇒ E + a * a | 642 |
| ⇒ E + T * a | 1364 | ⇒ E + F * a | 6426 |
| ⇒ E + a * a | 13646 | ⇒ E + T * a | 64264 |
| ⇒ T + a * a | 136462 | ⇒ E + T * F | 642646 |
| ⇒ F + a * a | 1364624 | ⇒ E + T | 6426463 |
| ⇒ a + a * a | 13646246 | ⇒ E | 64264631 |
상향식 파서는 왼쪽부터 스캔하지만, 리듀스는 오른쪽부터 완성되는 구문(핸들)을 우선으로 처리하기 때문에 우측 유도의 역순이다.
만약 같은 문장형태에서 서로 다른 두개 이상의 handle이 존재하면 “모호하다”라고 한다.
E→ E + E | E * E | ( E ) | id 에서, id + id * id에 대해 아래 우측 유도식을 거꾸로 올라가며 생각하면?
| E ⇒ E + E | E ⇒ E * E | |
| ⇒ E + E * E | ⇒ E * id | |
| ⇒ E + E * id | ⇒ E + E * id | |
| ⇒ E + id * id | ⇒ E + id * id | |
| ⇒ id + id * id | ⇒ id + id * id |
어디까지를 핸들로 보냐에 따라 갈리게 된다.
Shift-Reduce Parsing
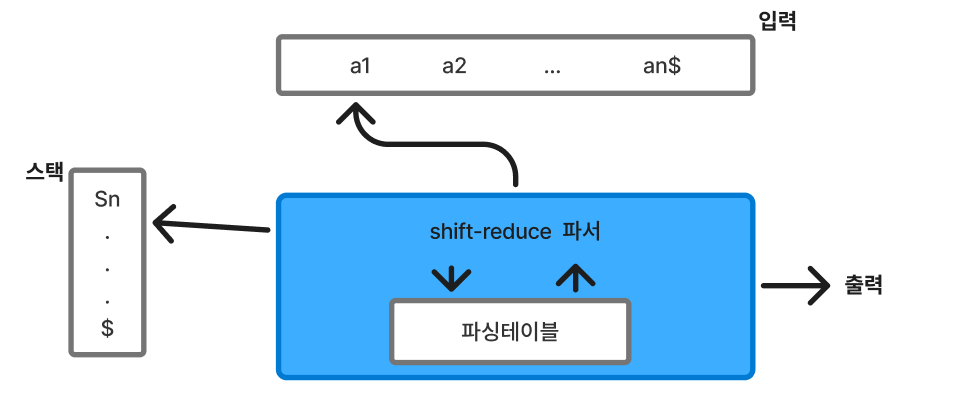
Shift: 스택의 top에 핸들이 나타날 때까지 계속해서 입력심벌을 스택에 옮겨 닮기
Reduce: 핸들을 찾으면 생성 규칙을 결정하여 lhs인 non-terminal로 바꿔치기
위 행동을 문법의 시작심벌에 이를 때까지 반복,수행
action
shift action
| stack | input | action |
| ( | 1+2+(3+4))+5 | shift 1 |
| (1 | +2+(3+4))+5 |
shift는 look-ahead token 하나를 스택에 옮긴다.
reduce action
| stack | input | action |
| (E+T | +(3+4))+5 | reduce E → E+T |
| (E | +(3+4))+5 |
Reduce는 스택 top에 있는 핸들 \(\beta\)를 non-terminal 심벌 \(X\)로 바꿔치기
- 단 생성규칙은 \(X \rightarrow \beta\)
Shift-Reduce Parsing 구문 분석 과정
예시)
문법
- \(E \rightarrow E+T\)
- \(E \rightarrow T\)
- \(T \rightarrow T*F\)
- \(T\rightarrow F\)
- \(F \rightarrow (E)\)
- \(F \rightarrow a\)
| 스택 | 입력 버퍼 | 구문분석행동 |
| $ | a+a*a$ | shift a |
| $a | +a*a$ | reduce F → a |
| $F | +a*a$ | reduce T → F |
| $T | +a*a$ | reduce E → T |
| $E | +a*a$ | shift + |
| $E+ | +a*a$ | shift a |
| $E+a | *a$ | reduce F → a |
| $E+F | *a$ | reduce T → F |
| $E+T | *a$ | shift * |
| $E+T* | *a$ | shift a |
| $E+T*a | $ | reduce F → a |
| $E+T*F | $ | reduce T → T*F |
| $E+T | $ | reduce E → E+T |
| $E | $ | accept |
- 초기상태: 스택에 $, 입력 버퍼에는 입력스트링과 $를 넣는다.
- accept 상태: 스택 top에 시작 심벌이 있고, 입력은 모두 본 상태
Shift-Reduce Parsing 구문 분석 과정의 ISSUES
1. Shift 할지 Reduce 할지 어떻게 아는가?
- 스택에 \(\beta\)가 있고, 입력 글자가 b일 때
- \(\beta = \alpha\gamma\) 이고, \(X \rightarrow \gamma\)가 있다면, 스택을 \(aX\)로 만들 것인가?
- 아니면, b를 스택에 옮겨 \(\beta b\)로 만들 것인가?
2. 여러 가지 reduce 방법이 있으면 어떻게 할 것인가?
- 스택 top 중 얼만큼을 떼어 핸들로 볼 것인가?
- 스택이 \(\beta = \alpha\gamma\) 일 때, \(X \rightarrow \gamma\) 규칙에 의해 reduce를 한다면 가능한 \(\gamma\)의 길이가 여러 가지 아닌가?
- ex) TF가 있을 때, F를 T로 볼 것인가? TF를 T로 볼 것인가?
- 스택이 \(\beta = \alpha\gamma\) 일 때, \(X \rightarrow \gamma\) 규칙에 의해 reduce를 한다면 가능한 \(\gamma\)의 길이가 여러 가지 아닌가?
해결 방법
파서상태(Parser State)라는 것들을 사용한다.
스택에 입력 심벌 shift 할 때, 관련 파서 상태도 끼워 넣는다
- ex) 0 ( 6 E 10 + 5
이 파서 상태가 무엇인지에 따라서 reduce 인지, shift인지, 얼마큼을 stack top으로 볼 것인지 등을 정할 수 있기에 애매한 일이 없다.
파싱테이블도 <상태> X <심벌들> 형태이다. 파서는 현재 파싱테이블을 보고, 현재 상태와 입력 심벌을 보고 shift 할지 reduce 할지 결정하고 (action table), 파서 상태도 변경시킨다(goto table)
LR Parsing Table
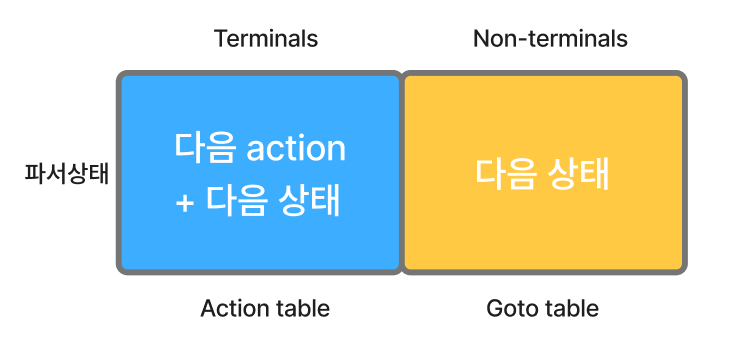
현재 상태 S와 입력 문자 a를 보고
- M[S,a] = shift S’ 라면 shift를 한다.
- push(a), push(S’)
- M[S,a] = reduce X → \(\alpha\)라면 reduce 한다.
- pop(2*| \(\alpha\)|), S’=top(), push(X), push(M[S’,X])
예시)
문법
- \(L \rightarrow L,S\)
- \(L \rightarrow S\)
- \(S \rightarrow a\)
파싱테이블
| a | , | & | L | S | |
| 0 | s3 | g1 | g2 | ||
| 1 | s4 | accept | |||
| 2 | L→S | L→S | |||
| 3 | S→a | S→a | |||
| 4 | s3 | g5 | |||
| 5 | L→L,S | L→L,S | 0 |
앞서 파싱테이블은 <상태> X <심벌들>이라고 했다. 0,1,2…들이 상태이며 a $ 등등이 심벌들이다.
파싱 과정 : a,a
| shift 3 | $0 | a,a$ |
| reduce S → a | $0 a 3 | ,a$ |
| goto 2 | $0 S | ,a$ |
| reduce L → S | $0 S 2 | ,a$ |
| goto 1 | $0 L | ,a$ |
| shift 4 | $0 L 1 | ,a$ |
| shift 3 | $0 L 1 , 4 | ,a$ |
| reduce S → a | $0 L 1 , 4 a 3 | $ |
| goto 5 | $0 L 1 , 4 S | $ |
| reduce L → L,S | $0 L 1 , 4 S 5 | $ |
| goto 1 | $0 L | $ |
| accept | $0 L 1 | $ |
| $accept | $ |
스택 top 상태 + 입력 심벌이면 액션 테이블이다. 논터미널과 그 뒤의 상태는 goto 테이블이다.
예를 들어 맨 처음 행의 경우 스택 top의 상태가 0이고, 입력문자가 a이므로 테이블의 M[0,a]을 확인해 본다. s3, 즉 shift 3을 하라고 나와있다. 이에 따라, a를 스택에 push 하고 상태 3번도 push 한다. 이런 식으로 쭉 진행하면 된다.
reduce와 goto는 짝이다, 한 번에 쓰는 경우도 있으나, 테이블 참조는 두 번해야 한다.
LR(0) 파싱 테이블 만들기
LR(0)이란 lookahead 없이 파싱 하고, shift-reduce 형태인 것을 말한다.
LR(0) 파싱테이블을 만들기 위해서는 LR(0) 아이템, Closure 등을 이용하여 파서 상태가 될만한 것들이 무엇인지 정하고, GOTO를 이용하여 각 파서 상태들 간의 상태 전이도를 만들고, 그 결과를 파싱 테이블에 담아야 한다.
LR(0)아이템
- rhs에 점(.) 심벌을 가진 생성 규칙이다.
- 생성 규칙의 형태가 A → XYZ 일 때, [A → .XYZ], [A→X.YZ], [A→XY.Z], [A→XYZ.]등은 모두 LR(0) 아이템이다.
- 생성 규칙이 A→ $\epsilon$ 일 때, [A→.] 은 LR(0) 아이템이다.
ex) E → num | (S)에서 등장할 수 있는 LR(0) Item은?
- [E → .num] [E → num.] [E→.(S)] [E→(.S)] [E→(S.)] [E→(S).]
closure
\(closure(I) = I ~\cup~ \{[B\rightarrow.g] ~ | ~ [A\rightarrow a.B\beta] \in closure(I), ~B \rightarrow g\in P~\}\)
- t가 terminal 심벌일 때
- \(closure([A\rightarrow a.t\beta])=\{[A\rightarrow a.t\beta]\}\)
- 점을 찍고, 토큰이면 자기 자신만
- X가 non-terminal 심벌일 때
- \(closure([A\rightarrow a.X\beta])=\{[A\rightarrow a.X\beta],[X\rightarrow.g]\}\)
- for all production \(X \rightarrow g\), recursively
- 점을 찍고, 논 터미널이면, 논 터미널이 가지는 걸 다 가져와서 rhs의 왼쪽에 점을 찍는다. 이것을 반복
I에 해당하는 집합에 몇 개의 아이템이 들어있나 보고, 아이템 각각에 대해 작업을 해주는 것이다. 완성 이후 변하지 않을 때까지 반복한다.
closure 예시 1
문법
- \(S' \rightarrow G\)
- \(G' \rightarrow E = E ~|~ f\)
- \(E \rightarrow E+T~|~T\)
- \(T \rightarrow T*f~|~f\)
\(closure(\{[S' \rightarrow.G]\})\)
\(= \{[S'\rightarrow.G],~[G\rightarrow.E=E],~[G\rightarrow.f],~[E\rightarrow.E+T],~[E\rightarrow.T],~[T\rightarrow.T*f],~[T\rightarrow.f]\}\)
closure 예시 2.
문법
- \(S' \rightarrow S\)
- \(S \rightarrow (L)~|~id\)
- \(L \rightarrow S~|~L,S\)
\(closure(\{[S' \rightarrow.S] \})\)
\(= \{[S'\rightarrow.S],~[S\rightarrow.(L)],~[S\rightarrow.id]\}\)
closure 정리
- 자기 자신을 가져오고
- 점 뒤에 Non-Terminal인지 확인
- 아니라면 토큰 앞에 점찍고 끝
- 맞으면 NonT 따라오는 애들 가져와서 점찍기
- 반복
goto
\(goto(I,X)\)
\(= closure(\{[A\rightarrow aX. \beta]~|~[A\rightarrow a.X\beta] \in I\})\)
문법 집합 \(I\)에 \([A\rightarrow a.X\beta]\) 가 있다면, \(X\)를 건너고 그 결과인 \([A\rightarrow aX. \beta]\)에 대한 closure를 계산하라
goto 예시 1.
문법
- \(S' \rightarrow G\)
- \(G' \rightarrow E = E ~|~ f\)
- \(E \rightarrow E+T~|~T\)
- \(T \rightarrow T*f~|~f\)
위의 문법에 대한 I가 아래와 같다고 하자
\(I = \{[G\rightarrow E.=E], [E\rightarrow E.+T]\}\) 일 때,
\(goto(I,+)\)
\(= closure(\{[E\rightarrow E+.T]\}) = \{[E\rightarrow E+.T],[T \rightarrow .T * f], [T\rightarrow.f]\}\)
- I 집합에서 +로 건너간다
- 클로저를 입힌다.
- 건너가서 클로저를 하는 게 핵심!
\(I = \{[E\rightarrow .T], [T\rightarrow .T*f],[T\rightarrow.f]\}\) 일 때,
\(goto(I,T)\)
\(= closure(\{[E\rightarrow T.], [T\rightarrow T.*f]\}) = \{[E\rightarrow T.], [T \rightarrow T.*f]\}\)
goto 정리
- goto 는 closure를 수반한다
- \(A \rightarrow \epsilon\)에 대한 goto는 없다.
상태
문법
- \(S' \rightarrow S\)
- \(S \rightarrow (L)~|~id\)
- \(L \rightarrow S~|~L,S\)

하나의 박스가 LR(0) 아이템의 집합을 의미한다. 모든 가능성을 박스에 넣고, 이를 상태라고 부른다.
의미
\([X \rightarrow \alpha.\beta]\)
- \(\alpha\)만큼은 이미 매치됨
- 앞으로 \(\beta\)가 올 가능성이 있다. (\(\beta\)는 마크 심벌이라고 한다.)
\(closure([A \rightarrow a.Xb])\)
- a까지 parse 됐고, X를 parse 할 것으로 기대하는 상태
파서 상태 만들기
- 생성 규칙 \(S' \rightarrow S\)를 추가 (Augmented Grammar)
- 시작 상태: \([S' \rightarrow .S]\)의 closure
- 그다음 상태들: 시작 상태부터 goto를 계산해서 만들어낸다. (\(C_0)\)
\(C_0\) 란?
\(C_0 = \{closure(\{[S' \rightarrow.S]\})\} ~\cup~ \{goto(I,X) ~|~I\in C_0,~ X\in V\}\)
추가된 생성규칙 \(S' \rightarrow .S\)에서부터 차례로 closure와 goto를 적용하여 얻은 모든 타당한 LR(0)를 말한다.
\(C_0 = \{I_0,~I_1,~...~,~I_n\}\) 라면 \(I_0\)은 \(\{S' \rightarrow S\}\)의 closure이고, 다른 것들은 여기서부터 각 마크 심벌에 따라 goto를 적용해서 만든 상태이다.
Item의 분류
- \([A\rightarrow X.Y] : X \neq e\)일 때 kernal item
- \([A\rightarrow .X]\): closure item
- \([A\rightarrow X.]\): reduce item
\(C_0\)과 Transition들
문법
- \(S \rightarrow (L) ~|~id\)
- \(L \rightarrow S ~|~L,S\)
- and augmented by \(S' \rightarrow S\)

- augmented 꼭 넣기
- 0으로 시작
- 커널 구하고, 클로저도 만들기
LR(0) 파싱테이블 구성하기
- 파서 상태로 \(C_0 = \{ I_0,~ I_1,~...~,~I_n\}\)과 transition 이용
- \(goto(I_1,a) = I_2\)면 \(M[I_1,a] = \text{shift}~ I_2\)
- \(goto(I_1,N) = I_2\)면 \(M[I_1,N] = \text{goto} ~I_2\)
- 상태 → 논터미널: goto
- 상태 → 터미널: shift
- 상태 \(I_k\)에서 터미널 \(a\)에 대한 트랜지션이 \(I_j\)로 간다고 하자.
- \(I_k\)안에 \(X \rightarrow \alpha.a\beta\)형태의 아이템이 있어서 \(goto(I_k, a)\)를 계산한 결과가 \(I_j\)라면 \(\text{action}[k,a] = \text{shift} ~j\)가 된다.
- \(I_1\)이 \([X\rightarrow\beta.]\)를 포함한다면 \(M[I_1,*] = \text{reduce}~ X \rightarrow \beta\)
- \(I_1\)이 \([S'\rightarrow S.]\)를 포함한다면 \(M[I_1,\$] = \text{accept}\)
LR(0) 파싱테이블
직전에 본 위 그림에 대한 LR(0) 파싱테이블은 아래와 같다.
| ( | ) | id | , | $ | S | L | |
| 0 | s2 | s1 | g3 | ||||
| 1 | S -> id | S -> id | S -> id | S -> id | S -> id | ||
| 2 | s2 | s1 | g6 | g4 | |||
| 3 | accept | ||||||
| 4 | s5 | s7 | |||||
| 5 | S -> (L) | S -> (L) | S -> (L) | S -> (L) | S -> (L) | ||
| 6 | L -> S | L -> S | L -> S | L -> S | L -> S | ||
| 7 | s2 | s1 | g8 | ||||
| 8 | L -> L,S | L -> L,S | L -> L,S | L -> L,S | L -> L,S |
shift/reduce 의미
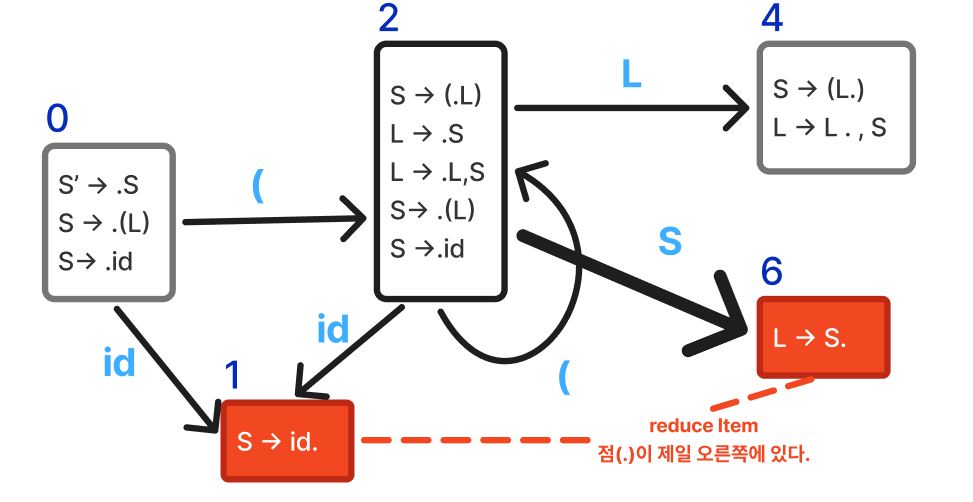
rhs만큼 stack에서 pop 하고 lhs를 대신 push 한다.
- 즉 \(X \rightarrow \beta.\) 라면 \(\beta\)를 pop 하고 \(X\)를 push
- table에서 다음 상태도 읽어서 함께 push
| derivation | stack | input | action |
| ((a),b) | 0 ( 2 ( 2 | a),b) | shift 1 |
| ((a),b) | 0 ( 2 ( 2 a 1 | ), b) | reduce S → id, goto 6 |
| ((S),b) | 0 ( 2 ( 2 S 6 | ),b) | reduce L → S, goto 4 |
SLR(simple LR) 파싱테이블
- 약간의 노력으로 LR(0) 보다 정교하게, conflict도 줄일 수 있다.
- \(I_1\)이 \([X \rightarrow \beta.]\)를 포함할 때: \(M[I_1, a] = \text{reduce} ~ X\rightarrow \beta\) (단 \(a \in FOLLOW(X)\))
- 팔로우가 나오는 순간에만 리듀스 한다는 뜻
- 나머지는 LR(0)과 똑같다
| ( | ) | id | , | $ | S | L | |
| 0 | s2 | s1 | g3 | ||||
| 1 | S -> id | S -> id | S -> id | ||||
| 2 | s2 | s1 | g6 | g4 | |||
| 3 | accept | ||||||
| 4 | s5 | s7 | |||||
| 5 | S -> (L) | S -> (L) | S -> (L) | ||||
| 6 | L -> S | L -> S | |||||
| 7 | s2 | s1 | g8 | ||||
| 8 | L -> L,S | L -> L,S |
\(FOLLOW(S) = \{\$,),~ ,\}\)
\(FOLLOW(L) = \{), ~,\}\)
앞서 본 LR(0)과 거의 다 비슷하지만, 팔로우에 있을 때만 reduce를 하므로, 테이블에 reduce 숫자가 줄은 것을 확인할 수 있다.
SLR(simple LR)의 추가 예시
1. 문법
- \(S' \rightarrow E\)
- \(E \rightarrow E + T\)
- \( E \rightarrow T\)
- \( T \rightarrow T * F\)
- \( T \rightarrow F\)
- \( F \rightarrow (E)\)
- \( F \rightarrow id\)
2. FOLLOW 계산
- \(FOLLOW(E) = \{\$, +,)\}\)
- \(FOLLOW(T) = \{*, +,),\$\}\)
- \(FOLLOW(F) = \{*, +,),\$\}\)
- \(FOLLOW(E) = \{\$, +,)\}\)
3. \(C_0\) 계산
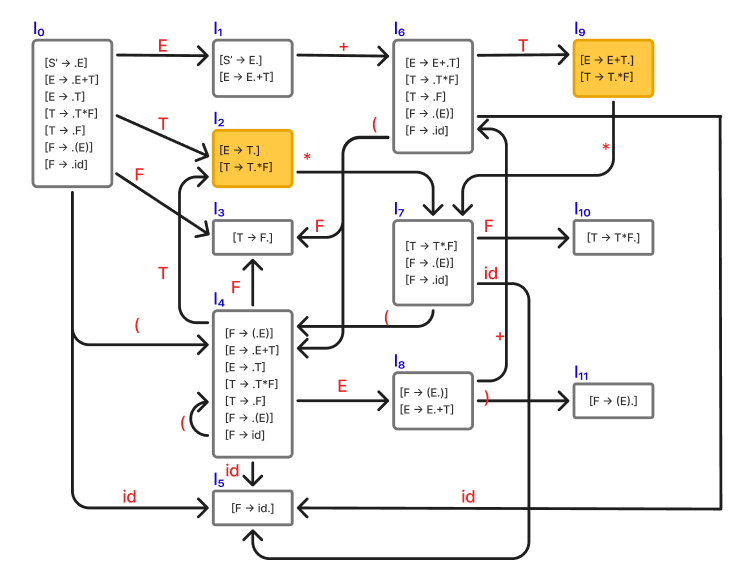
위와 같이 모호성이 있기 때문에 현실적으로는 LR(0)을 쓸 수 없다.
4. SLR 파싱 테이블
| id | + | * | ( | ) | $ | E | T | F | |
| 0 | s5 | s4 | g1 | g2 | g3 | ||||
| 1 | s6 | acc | |||||||
| 2 | r2 | s7 | r2 | r2 | |||||
| 3 | r4 | r4 | r4 | r4 | |||||
| 4 | s5 | s4 | g8 | g2 | g3 | ||||
| 5 | r6 | r6 | r6 | r6 | |||||
| 6 | s5 | s4 | g9 | g3 | |||||
| 7 | s5 | s4 | g10 | ||||||
| 8 | s6 | s11 | |||||||
| 9 | r1 | s7 | r1 | r1 | |||||
| 10 | r3 | r3 | r3 | r3 | |||||
| 11 | r5 | r5 | r5 | r5 |
[2,id] [2,(]에 reduce가 없는 것을 볼 수 있다. 팔로우에 없으니 리듀스를 넣지 않는 것이다.
5. a*a+a를 구문분석하면 아래와 같다.
| 스택 | 입력 | 구문 분석 내용 | 출력 |
| 0 | a*a+a$ | shift 5 | |
| 0a5 | *a+a$ | reduce 6 F -> id | 6 |
| 0F | *a+a$ | goto 3 | |
| 0F3 | *a+a$ | reduce 4 T -> F | 4 |
| 0T | *a+a$ | goto 2 | |
| 0T2 | *a+a$ | shift 7 | |
| 0T2*7 | *a+a$ | shift 5 | |
| 0T2*7a5 | +a$ | reduce 6 F -> id | 6 |
| 0T2*7F | +a$ | goto 10 | |
| 0T2*7F10 | +a$ | reduce 3 T -> T*F | 3 |
| 0T | +a$ | goto 2 | |
| 0T2 | +a$ | reduce 2 E -> T | 2 |
| 0E | +a$ | goto 1 | |
| 0E1 | +a$ | shift 6 | |
| 0E1+6 | a$ | shift 5 | |
| 0E1+6a5 | $ | reduce 6 F -> id | 6 |
| 0E1+6F | $ | goto 3 | |
| 0E1+6F3 | $ | reduce 4 T -> F | 4 |
| 0E1+6T | $ | goto 9 | |
| 0E1+6T9 | $ | reduce 1 E -> E+T | 1 |
| 0E | $ | goto 1 | |
| 0E1 | $ | accept |
수업에서 들은 팁) 이해가 안 된다면 기계적으로 슥슥,,
SLR 파서의 한계
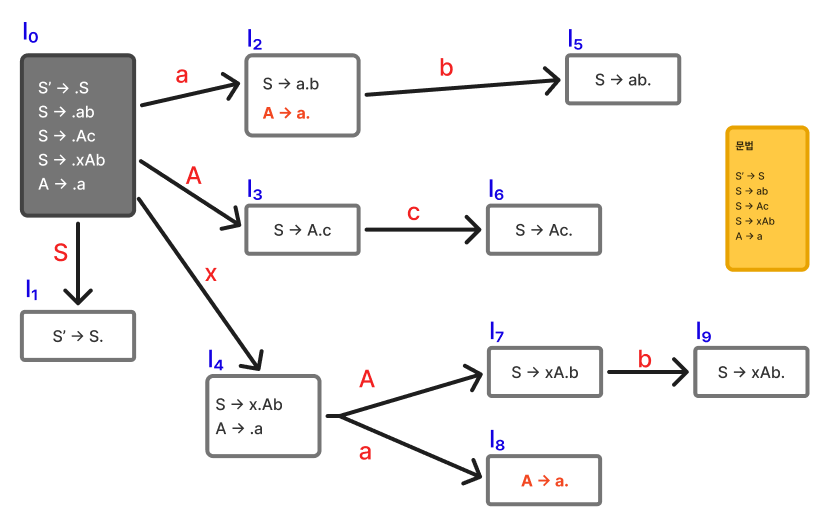
\(FOLLOW(A) = \{b,c\}\) 이므로 SLR에서는 \(b\)가 나오면 \(A \rightarrow a.\)를 reduce 한다. ( \(I_2, I_8)\)
그런데 \(I_2\)에서 입력이 \(b\)일 때 \(A \rightarrow a\)를 reduce 할지 \(I_5\)로 shift 할지 모른다.. 이것이 SLR의 한계

입력이 각각 ab, xab, ac일 때를 보자. “ab”의 경우, 앞에 아무것도 없을 때, a를 받고 다음이 b면 shift 한다.
“xab”의 경우 앞에 x를 하나 받은 상태일 때, a를 받고 다음이 b면 reduce 해서 A를 만든다.
그런데 “ac”의 경우, 앞에 아무것도 없을 때 a를 받고 다음이 c면 reduce 해야 한다.
"ab"와 "ac"는 둘 다 문장 맨 앞의 a라는 동일한 시작 상황을 가지지만 뒤따라오는 입력에 따라 하나는 Shift 다른 하나는 Reduce를 해야 하는 것이다.
만약 \(I_2\) 상태에서 다음 입력으로 b가 들어온다면, 문맥상으로는 ab를 만들기 위해 shift 해야 하지만, 파서는 FOLLOW(A)에 b가 있는 것을 확인했으므로 reduce를 해도 된다고 판단해 버린다.
즉 FOLLOW만으로는 이러한 구체적인 문맥 차이를 구별하는 데 한계가 있다. 이에 따라 현재 상태가 구체적으로 어떤 경로를 통해 왔는지까지 확인할 필요가 있고, 이를 위해 등장한 것이 LR(1) parsing이다.
LR(1) 파서
LR(1)
- 한 개의 lookahead를 통해 얻을 수 있는 것들을 모두 얻어 parsing tree를 구성하는 것이다
- LR(1) 문법: LR(1) parsing으로 parsing 되는 CFG
LR(1) vs LR(0)은 아이템의 차이이다.
- 둘 다 parser 상태는 set of items
- 그러나 LR(1) item = LR(0) item + lookahead 심벌
- LR(0) item : $S \rightarrow .S + E$
- LR(1) item: $S \rightarrow .S +E, +$
LR(1) 아이템
\(\text{LR(1) item} ~ = ~[X\rightarrow \alpha.\beta,~y]\)
스택에 이미 \(\alpha\)까지 이미 match 되었고, 그다음으로 \(\beta y\)가 들어올 수 있는 상태이다.
Lookahead 심벌 in LR(1) item
- 해당 생성규칙으로 유도된 직후에 나타난 심벌
- reduce 할 때만 쓰임
- \([X \rightarrow \alpha.\beta, \{x_1,~...~,x_n\}]\) 또는 \([X \rightarrow \alpha.\beta,~ x_1/.../x_n]\) 는 \([X \rightarrow \alpha.\beta, ~x_1] ~...~[X \rightarrow \alpha.\beta, ~x_n]\) 라는 뜻이다. 즉 lookahead가 여러 개 일 수도 있음
LR(1) closure, goto
\(closure(I) = I ~\cup~\{[B\rightarrow.g,~ FIRST(bz)]\} ~ | ~ [A\rightarrow~a.Bb,~z]~\in~closure(I),~B\rightarrow g~\in~ P\}\)
\(goto(I,X)\)
\(= closure(\{A\rightarrow aX.b,~z\}) ~ | ~ [A\rightarrow a.Xb,~z] ~\in~I\}\)
closure는 LR(0) closure와 비슷하나, lookahead를 기록하며 계산하는 것만 다르고, goto는 똑같다.
예시)
문법
- \(S' \rightarrow S\)
- \(S \rightarrow E+S~|~E\)
- \( E \rightarrow num\)
- \( FIRST(S) = FIRST(E) = \{num\}\)
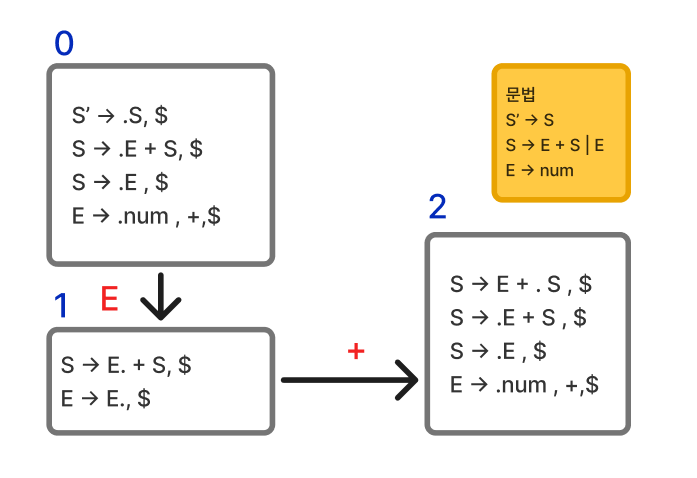
시작 상태는 \([S' \rightarrow S,~ \$]\) 의 클로저다.
\(closure(\{[S' \rightarrow.S,~\$]\})\)
\(= \{[S' \rightarrow .S,~\$],[S \rightarrow .E+S, ~\$], [S \rightarrow .E, ~\$], [E \rightarrow .num, ~ +], [E \rightarrow .num, ~ \$]\}\)
- \([E \rightarrow .num, ~ +], [E \rightarrow .num, ~ \$]\) 이걸 \([E \rightarrow .num, ~ +/\$]\)처럼 나타낼 수도 있다.
\(I1 = \{[S\rightarrow E. +S,~\$], [S\rightarrow E.,~\$]\}\) 일 때,
\(goto(I1,'+')\)
\(= ~closure(\{[S \rightarrow E+.S, ~\$]\})\)
\(= \{[S\rightarrow E+.S, \$],[S\rightarrow.E+S,\$],[S\rightarrow.E,\$],[E\rightarrow.num, +/\$]\}\)
goto는 lookahead가 변하지 않는 것을 할 수 있다.
LR(1) 파서 상태와 \(C_1\)와 전이도
Lookahead 무시하고 LR(0) 그릴 때와 똑같이 그리면 되지만, 단 내용이 똑같아도 Lookahead가 달라서 상태를 새로 만들어야 하는 상황이 생길 수도 있다.
LR(1) 파싱 테이블
Reduction 빼고 LR(0)과 동일하다
- \(goto(I_1,a) = I_2$면 $M[I_1,a] = \text{shift}~ I_2\)
- \(goto(I_1,N) = I_2$면 $M[I_1,N] = \text{goto} ~I_2\)
- \(I_1$이 $M[X\rightarrow \beta.,z]\)를 포함하면: \(M[I_1,z] = \text{reduce}~X\rightarrow\beta\)
- \(I_1$이 $[S'\rightarrow S.]\)를 포함한다면 \(M[I_1,\$] = \text{accept}\)
lookahead를 가지고 다니다가 그 지점에서만 reduce 한다
파싱테이블 일부
| + | $ | E | |
| 0 | g1 | ||
| 1 | s2 | S->E |
LRLA 파서
LR(1) 파싱의 문제점은 파서 상태 개수가 너무 많다.
LALR 파싱은 LR에서 두 상태의 core가 똑같으면 하나의 상태로 묶는다. SLR보다는 아주 많이 정교하고, LR(1)보다는 이론적으로 less powerful하나 실제 처리할 수 있는 의미 잇는 문법의 종류가 거의 동일하다.
파서들의 개수는 일반적으로 SLR과 동일하며, 이는 LR(1) 보다 현저히 적은 개수이다.
LRLA(1) 파서 만드는 방법
- \(C_1\)에서 작성하는 방법
- LR(1) 아이템들과 \(C_1\)을 만든다
- 같은 core를 가진 LR(1) 아이템 집합들을 한 개의 LR(0) 아이템 집합으로 만든다. 이때 각 아이템의 lookahead는 이들 LR(1) 아이템의 lookahead 합집합으로 구성한다.
- 단점은 LR(1) 파서를 다 만들고 다시 합쳐야 한다는 것이다. 즉 상태 수 문제를 극복하지 않는다.
- \(C_0\)에서 작성하는 방법
- LR(0) 아이템들과 \(C_0\)을 만든다.
- 파싱 테이블의 shift와 accept 그리고 GOTO 행동은 SLR과 같고, reduce만 수정한다.
구문 분석 방법 정리
- LL 파싱 테이블
- Non-terminal x terminal = 생성 규칙
- FIRST/FOLLOW로 계산
- LR 파싱 테이블
- LR states x terminals = {shift/reduce}
- LR states x non-terminals = goto
- 아이템의 closure와 파서 상태들의 goto로 계산
- 어떤 문법이
- LL(1)이라는 것은 LL(1) 테이블에 conflict가 없다는 뜻
- LR(0)이라는 것은 LR(0) 테이블에 conflict가 없다는 뜻
- SLR이라는 것은 SLR 테이블에 conflict가 없다는 뜻
- LALR(1)이라는 것은 LALR(1) 테이블에 conflict가 없다는 뜻
- LR(1)이라는 것은 LR(1) 테이블에 conflict가 없다는 뜻
- …
- \(LR(k) \subseteq LR(k+1)\)
- \(LL(k) \subseteq LL(k+1)\)
- \(LL(k) \subseteq LR(k)\)
- \(LR(0) \subseteq SLR\)
- \(LALR(1) \subseteq LR(1)\)